
Ik vergeleek AOCI + Codex met native Codex in een productierepository van ongeveer 360.000 regels. In deze test zag ik geen efficiëntiewinst: de doorlooptijd en het aantal ongecachete inputtokens namen in alle vier scenario’s toe. Eén taak werd geblokkeerd door de validatie bij het inlezen.
Bij het best vergelijkbare, afgeronde takenpaar voor de volledige repository scoorden beide antwoorden 6/6. AOCI kostte 2,93× zoveel tijd en gebruikte 3,40× zoveel ongecachete inputtokens. De eenmalige indexering van bijna vier uur is daarin niet meegerekend.
Voor mijn eigen werk heb ik voorlopig geen toepassing gevonden waarin AOCI voordeel oplevert.
Mijn principe: elke extra laag moet zijn voordeel aantonen
Ik geef een agent bij voorkeur het probleem en de benodigde tools, waarna hij zelf bepaalt hoe hij die gebruikt.
Indexen, workflows en andere hulpmiddelen zijn het proberen waard. Of ik ze behoud, hangt af van één concrete vraag: wordt dezelfde taak, bij vergelijkbare kwaliteit, sneller, goedkoper of betrouwbaarder uitgevoerd?
GitHub-sterren en aanbevelingen helpen mij tools te ontdekken. Vergelijkingen met echte taken bepalen of ik ze gebruik. Naarmate modellen beter worden, wil ik duidelijker bewijs voor het nut van extra lagen.
Details van de test
Een code-index ordent vooraf de repository om relevante informatie vindbaar te maken. Vergelijk het met de inhoudsopgave van een boek. Die maken en lezen kost ook iets.
Beide configuraties gebruikten gpt-6.1-sol / low. Elke taak begon in een nieuwe sessie. Twee taken betroffen acht bestanden; twee de volledige repository.
| Taak | Seconden: native → AOCI | Ongecachete inputtokens: native → AOCI | Resultaat |
|---|---|---|---|
| Aanroepketen volgen, 8 bestanden | 69 → 105 | 36.479 → 44.068 | Beide gaven antwoord |
| Bugdiagnose, 8 bestanden | 26 → 58 | 9.445 → 28.210 | Beide oplossingen slaagden voor 15 tests |
| Ontbrekende bronwaarden volgen, volledige repository | 106 → 230 | 60.803 → 169.731 | AOCI geblokkeerd bij validatie; geen inhoudelijk antwoord |
| Van voorspelling tot release, volledige repository | 111 → 326 | 61.495 → 209.236 | Beide antwoorden scoorden 6/6 |
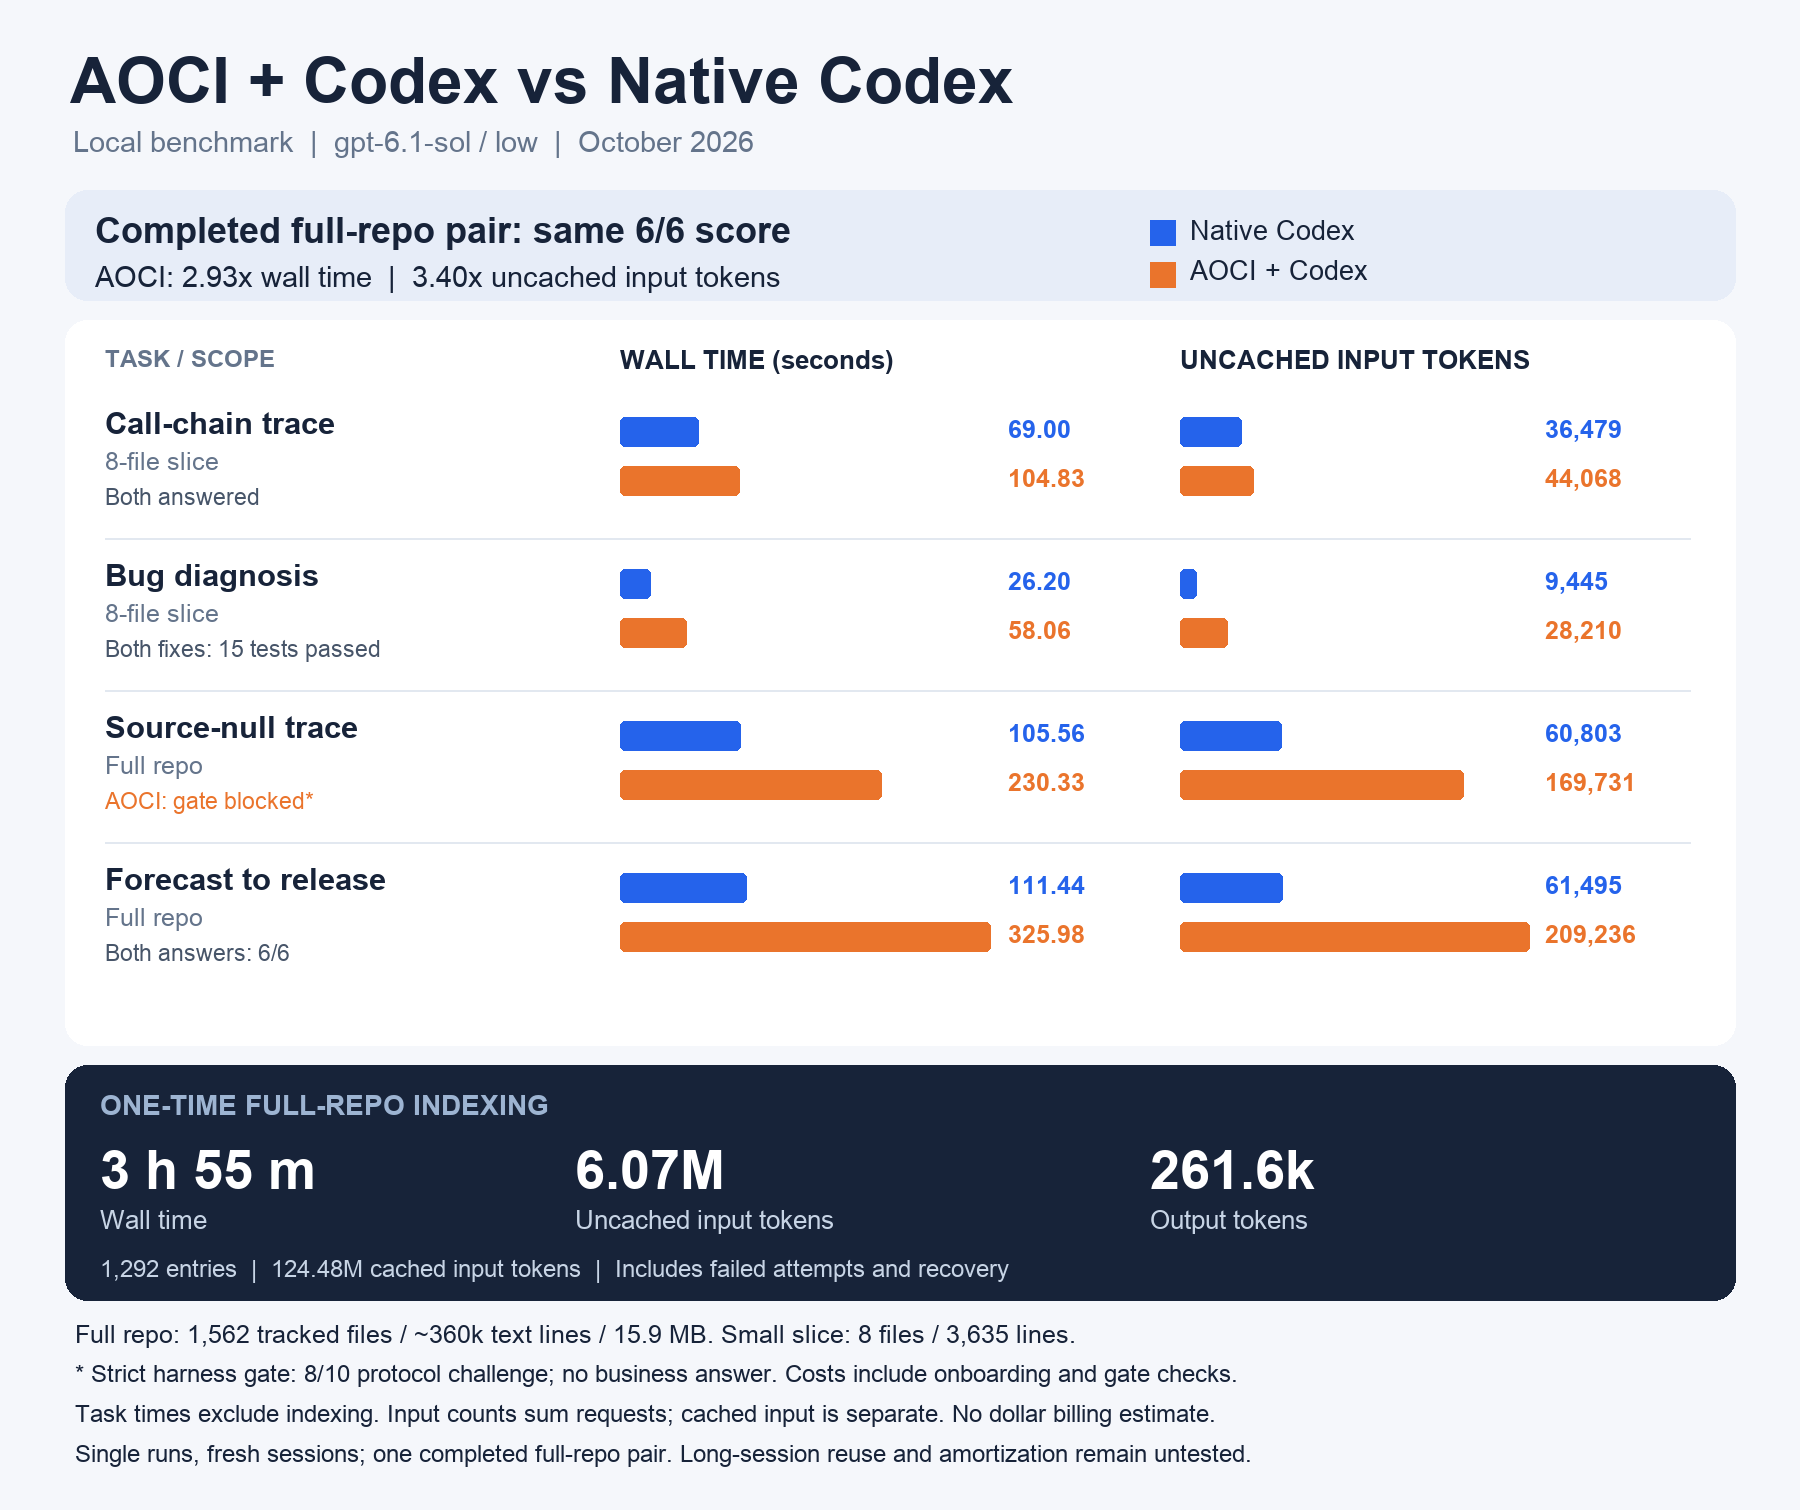
De eenmalige indexering duurde ongeveer 3 uur en 55 minuten en gebruikte 6,07 miljoen ongecachete inputtokens, inclusief mislukte pogingen en herstel. De taaktijden sluiten indexering uit. Ongecachete inputtokens zijn geen directe kostenraming.
Mogelijke verklaringen
- Ook in een grote repository kan een taak klein zijn. Met een duidelijk startpunt, een falend voorbeeld of een aanroepketen kan native Codex de relevante code vinden via zoeken en enkele bronbestanden.
- De index heeft vaste inleeskosten. Beide taken voor de volledige repository laadden alle 22 indexdelen en doorliepen ontvangstbevestiging en cognitieve controlevragen. Precieze antwoorden vereisten nog steeds controle in de broncode, waardoor beide soorten leeswerk zich kunnen opstapelen.
- Hergebruik is nog niet getest. Nieuwe sessies herhaalden de inleeskosten. Meerdere taken in één sessie kunnen een ander resultaat geven.
Dit zijn mogelijke verklaringen. Ik heb index laden, validatie en inhoudelijke analyse niet afzonderlijk getimed en kan de vertraging daarom niet precies toeschrijven.
Het gaat om één uitvoering per scenario, met slechts één afgerond takenpaar voor de volledige repository. Langdurig hergebruik en het terugverdienen van de indexering zijn nog niet getest. De resultaten ondersteunen mijn huidige keuze, zonder vast te stellen hoe AOCI in alle repositories en taken presteert.
Heb je duidelijke winst gemeten? Dan hoor ik graag bij welke taak, hoe je de tool hebt aangesloten en waar het voordeel vandaan kwam.