
在一个约 36 万行的生产代码库里,我对比了 AOCI + Codex 与原生 Codex。这次没有看到效率收益:四个场景的耗时和未缓存输入 token 都增加了,其中一个任务被接入验证门槛阻断。
最有可比性的一组全仓任务中,两边答案都得到 6/6 分,但 AOCI 的耗时是原生 Codex 的 2.93 倍,未缓存输入 token 是 3.40 倍。这还没有计入近四小时的一次性索引准备。
目前,我还没有找到让 AOCI 在自己工作场景中产生收益的用法。
我的原则:增加一层,就验证一层的收益
我的倾向是让 Agent 直接面对问题,提供必要工具,再让它根据任务选择如何使用。
索引、工作流和其他脚手架都可以尝试。是否保留,取决于一个具体问题:同样的任务、相近的质量,是否更快、更省,或者更可靠?
GitHub 星数和推荐文章帮助我发现工具,真实任务的对照结果决定我是否使用。随着模型能力提升,我对这些中间层的收益证据也会要求得更明确。
实测细节
索引工具会预先整理代码,帮助 Agent 定位相关内容。可以把它理解成给一本书建立目录;建目录、读目录,也有成本。
这次使用相同的模型配置 gpt-6.1-sol / low,每个任务从独立会话开始。两个任务覆盖 8 个文件,两个覆盖全仓。
| 任务 | 耗时:原生 → AOCI | 未缓存输入 token:原生 → AOCI | 结果 |
|---|---|---|---|
| 调用链追踪,8 个文件 | 69 → 105 秒 | 36,479 → 44,068 | 两边均回答 |
| Bug 诊断,8 个文件 | 26 → 58 秒 | 9,445 → 28,210 | 两边修复均通过 15 项测试 |
| 源数据空值追踪,全仓 | 106 → 230 秒 | 60,803 → 169,731 | AOCI 被接入门槛阻断,未给出业务答案 |
| 预测到发布链路,全仓 | 111 → 326 秒 | 61,495 → 209,236 | 两边答案均为 6/6 |
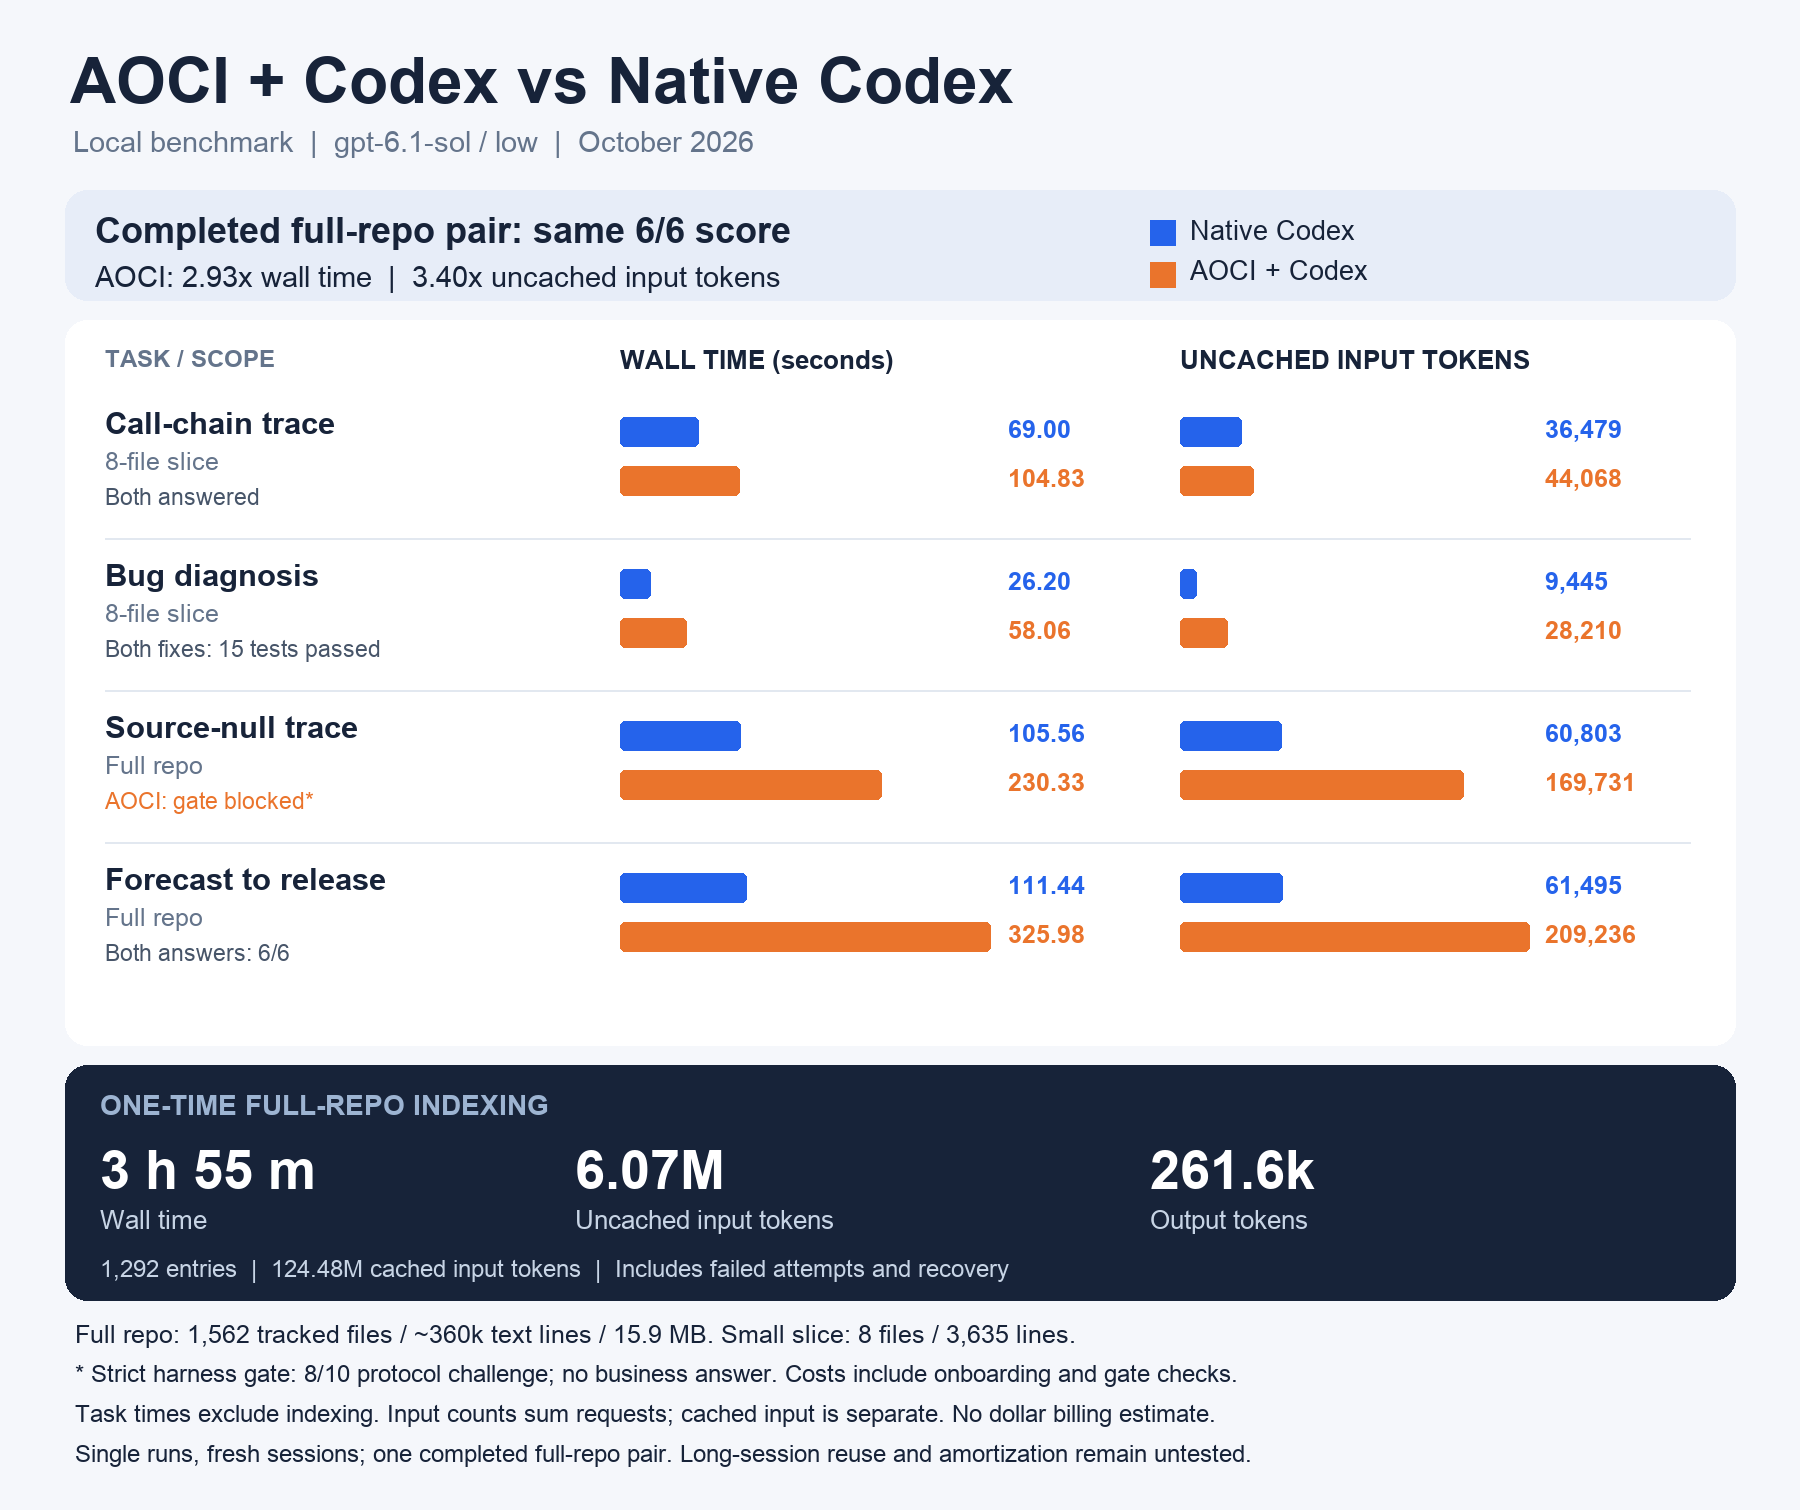
一次性全仓索引准备耗时约 3 小时 55 分钟,消耗约 607 万未缓存输入 token,包含失败尝试与恢复。表中的任务耗时不包含索引准备,未缓存输入 token 也不能直接等同于费用。
为什么可能出现这种结果
- 大仓库里的任务,范围仍然可以很小。 有明确入口、失败样例或调用链时,原生 Codex 通过搜索和少量源码读取就能定位问题。
- 索引有固定接入成本。 两次全仓任务都加载了完整索引的 22 个分块,并执行交付确认和认知挑战。精确回答仍需回到源码验证,可能同时承担读索引和读代码的成本。
- 复用优势尚未覆盖。 每道题使用新会话,接入成本重复发生。同一会话连续处理多个任务,可能获得不同结果。
这些是解释方向。我没有分别测量索引加载、验证和业务推理耗时,无法精确归因。
这次是单次运行,只有一组完成的全仓配对,也没有验证长期复用与成本摊销。它支持我当前的使用决定,无法推广到所有代码库和任务。
如果你已经测出明确收益,我最想了解的是:什么任务、怎样接入,以及收益具体来自哪里。